Private KI bedeutet nicht einfach nur eine datenschutzfreundlichere Einstellung bei einem öffentlichen Chatbot. Es geht um eine klare, nachvollziehbare Grenze: Das KI-Modell läuft entweder auf einem Gerät, das Sie selbst kontrollieren, oder auf einem Server, dessen Infrastruktur so ausgelegt ist, dass der Betreiber keinen Einblick in Ihre Eingaben (Prompts) erhält.
Viele Anbieter beschränken sich auf die Aussage: „Wir trainieren nicht mit Ihren Daten.“ Doch damit ist nur eine von mehreren wichtigen Datenschutzfragen beantwortet. Und längst nicht die entscheidende.
In diesem Leitfaden erklären wir, was private KI bedeutet, wie ein privates KI-Modell und die private KI-Inferenz tatsächlich funktionieren, welche zwei grundlegenden Möglichkeiten es gibt, private KI zu nutzen, welche Datenschutzstufen bei gehosteten Lösungen existieren und warum die Zusage „Wir trainieren nicht mit Ihren Daten“ allein nicht ausreicht.
Sollten Ihnen einige Begriffe in diesem Artikel neu sein, finden Sie am Ende einen Glossar mit den wichtigsten hier erwähnten Begriffen.
💡 Private KI bedeutet eine klar definierte Datenschutzgrenze – nicht einfach eine Einstellung bei einem fremden Dienst.
Das Wichtigste auf einen Blick
- Private KI bedeutet, dass das KI-Modell, Ihre Daten und die Verarbeitung Ihrer Anfragen innerhalb einer klar definierten Grenze bleiben.
- Der Rechner, auf dem das Modell läuft, muss Ihre Texte zumindest vorübergehend verarbeiten können. Entscheidend ist, wem dieser Rechner gehört und ob andere Personen Zugriff auf Ihre Eingaben haben.
- Es gibt zwei Möglichkeiten: Sie betreiben die KI selbst oder Sie nutzen einen externen Hosting-Anbieter. Dabei gilt: Nicht jeder Hosting-Anbieter bietet dasselbe Maß an Datenschutz.
- Das KI-Training mit Ihren Daten bei ChatGPT zu deaktivieren ist nur das Minimum – nicht das eigentliche Ziel.
Was ist private KI?
Private KI bezeichnet jedes System, bei dem das KI-Modell, Ihre Dokumente und der Verarbeitungsschritt, in dem die Antwort entsteht, innerhalb einer klar benennbaren Sicherheitsgrenze bleiben. Ihre Prompts werden nicht standardmäßig an eine öffentliche API übermittelt. Sie werden auch nicht zum Training des Modells eines anderen Anbieters verwendet – entweder weil sie diesen Anbieter gar nicht erst erreichen oder weil es aufgrund der Architektur des Systems nicht möglich ist, eine solche Nutzung einfach durch eine Einstellung auszuschließen.
Bei öffentlicher KI ist es genau umgekehrt: Sie senden Ihre Texte an einen externen Anbieter. Dieser kann sie während der Verarbeitung durch das KI-Modell lesen. Außerdem kann er sie protokollieren, speichern und zum Training verwenden.
Bringen Sie das Modell zu Ihren Daten. Senden Sie nicht Ihre Daten an das Modell.
Private KI: Bei privater KI bleiben das Modell, Ihre Daten und die Verarbeitung Ihrer Anfragen innerhalb einer klar definierten Grenze. Der Rechner, auf dem das Modell läuft, muss Ihre Texte während der Verarbeitung sehen können. Dieses Zeitfenster wird als „Daten in Verwendung“ (Data in Use) bezeichnet. Weder die Verschlüsselung bei der Übertragung noch die Verschlüsselung gespeicherter Daten schützt diesen Verarbeitungsschritt. Entscheidend ist vielmehr, wem der Rechner gehört und ob andere Personen die Texte lesen oder zum Trainieren verwenden können.
Das ist die architektonische Bedeutung von privater KI. Daneben gibt es zwei weitere Verwendungen desselben Begriffs:
In der Forschung bezeichnet private KI auch kryptografische Verfahren wie homomorphe Verschlüsselung, sichere Mehrparteienberechnung und föderiertes Lernen. Sie sollen Berechnungen mit Daten ermöglichen, die für andere nicht im Klartext sichtbar sind. Diese Verfahren sind real und relevant. Allerdings entsprechen sie nicht der Art und Weise, wie die meisten Menschen 2026 mit einem großen KI-Modell chatten.
Marketer wiederum verwenden den Begriff private KI für gehostete Chatbots, bei denen lediglich die Option zum KI-Training deaktiviert wurde. Betrachten Sie das als Werbung; es ist keine echte Datenschutzgrenze.
Private KI ist auch nicht vergleichbar mit den „Datenschutzeinstellungen für KI“. Einstellungen befinden sich auf dem Dienst eines anderen Anbieters. Die eigentliche Architektur bestimmt, wo sich die Grafikkarte befindet, auf der Ihre Eingaben verarbeitet werden.
Zwei Möglichkeiten zum Betrieb privater KI
- Sie betreiben die KI selbst. Das kann auf einem Laptop, Smartphone, privaten KI-Server oder einem vollständig vom Internet getrennten Rechner geschehen. Die Daten verlassen Ihr Gerät nicht, solange Sie keinen externen Zugang ermöglichen (beispielsweise in Form eines öffentlich erreichbaren Netzwerkports, eines Plug-ins oder eines API-Schlüssels).
- Ein Hosting-Anbieter betreibt die KI. Sie senden Ihren Prompt an den Anbieter und vertrauen auf dessen Sicherheitskonzept. Dieses kann auf vertraglichen Zusicherungen, einer Verarbeitung ohne Datenspeicherung, einer Speicherung ohne Zugriffsmöglichkeit des Anbieters auf frühere Chats oder auf Hardware beruhen, die den Verarbeitungsvorgang isoliert.
Bei der zweiten Möglichkeit handelt es sich nicht um ein einzelnes Produkt. Was dahinter steht sind verschiedene Sicherheitsversprechen.
Das Spektrum privater KI
| Ebene | Wer kann den Live-Prompt sehen? | Wie wird der Prompt geschützt? | Beispiel |
|---|---|---|---|
| Lokal / selbst gehostet | Personen mit Zugriff auf den Rechner | Physik: Durch die lokale Verarbeitung bleibt die Eingabe auf der von Ihnen kontrollierten Hardware. Standardmäßig gibt es keinen externen Inferenzanbieter. | Ollama, LM Studio |
| Vertrauliches Hosting | Der Dienstbetreiber sollte die Eingabe auch während der Verarbeitung nicht einsehen können. | Hardwarebasierte Isolierung: Vertrauenswürdige Hardware schirmt Modell und Daten ab. Eine kryptografische Attestierung ermöglicht die Überprüfung, ob tatsächlich der freigegebene Programmcode ausgeführt wird. | Venice AI in TEE-/E2EE-Modi, Architekturen wie Apple Private Cloud Compute |
| Zero-Access-Speicherung | Der Anbieter kann den Prompt während der Antwortverarbeitung lesen, sollte aber später nicht auf gespeicherte Unterhaltungen zugreifen können. | Gespeicherte Chats werden so verschlüsselt, dass der Anbieter sie später weder entschlüsseln noch einsehen kann. | Lumo |
| Hosting ohne Datenspeicherung | Der Anbieter kann die Eingabe während der Verarbeitung lesen und möglicherweise vorübergehend verarbeiten oder protokollieren. | Richtlinien und technische Prozesse: Der Anbieter verspricht, die Daten nach der Verarbeitung zu löschen und sie nicht zum Modelltraining zu verwenden. | Brave Leo AI, Duck.ai |
| Mainstream-KI, mit deaktiviertem Training | Der Anbieter kann die Eingabe lesen, speichern, protokollieren, überprüfen oder offenlegen (im Rahmen seiner Richtlinien und gesetzlichen Verpflichtungen). | Eine Einstellung verhindert die reguläre Verwendung Ihrer Daten zum KI-Training, nicht aber den Zugriff während des Betriebs des Dienstes. | ChatGPT oder Claude mit deaktiviertem Training |
Wenn Sie nicht sagen können, auf welchem Rechner Ihre Eingabe verarbeitet wurde, haben Sie lediglich ein Versprechen – aber keine architektonisch abgesicherte private KI.
Wie funktioniert private KI?
Zunächst eine einfache Erklärung: Sie laden ein KI-Modell. Sie stellen eine Frage. Das Modell antwortet. Ob Ihre Daten dabei geschützt sind, entscheidet sich vor allem zwischen den beiden letzten Schritten: während Ihre Frage im Arbeitsspeicher des Rechners liegt, auf dem die Verarbeitung stattfindet.
Was ist ein privates KI-Modell?
Ein privates KI-Modell kann in der Regel eine von drei Formen annehmen, die häufig miteinander verwechselt werden:
- Offene Modellgewichte, die Sie herunterladen und selbst speichern: Dazu gehören Modelle der Familien Llama, Mistral, Gemma, Qwen und Phi.
- Ein Modell eines Anbieters, das in Ihrer privaten Cloud oder Ihrem eigenen Rechenzentrum betrieben wird.
- Ein gehostetes Modell, das sich nicht in Ihrem Besitz befindet.
Beim Herunterladen und Speichern der Modellgewichte sind Ihre Prompts nicht automatisch geschützt. Sobald Sie das Modell über einen öffentlich zugänglichen Endpunkt bereitstellen, kann es öffentlich erreichbar sein – selbst wenn Sie die Modelldateien besitzen.
Was bedeutet private KI-Inferenz?
In der KI bezeichnet Inferenz den Vorgang, bei dem ein trainiertes Modell neue Eingaben verarbeitet und daraus ein Ergebnis erzeugt. Das kann beispielsweise eine Antwort, eine Vorhersage, eine Klassifizierung oder ein generiertes Bild sein.
Bei der privaten KI-Inferenz findet dieser Verarbeitungsschritt statt, ohne dass Ihre Daten im Klartext die von Ihnen festgelegte Sicherheitsgrenze verlassen. Bei einer öffentlichen API liegen Ihre Daten im Klartext auf der Grafikkarte (GPU) des Anbieters. Auch ein Hosting-Anbieter, der keine Daten speichert, sieht sie zumindest während dieses kurzen Zeitraums.
Eine Speicherung ohne Anbieterzugriff (Zero Access) verschlüsselt den Chatverlauf erst im Nachhinein. Vergleichbar mit einem Sachbearbeiter, der den Brief erst lesen muss, um darauf antworten zu können (und ihn anschließend aber in einem verschlossenen Archiv ablegt, zu dem er keinen Schlüssel besitzt).
Eine vertrauenswürdige Ausführungsumgebung (Trusted Execution Environment, TEE) versucht dagegen, bereits diesen Verarbeitungsschritt innerhalb eines geschützten Hardwarebereichs ablaufen zu lassen, den der Betreiber nicht einsehen kann. Allerdings sollten Sie die kryptografische Attestierung überprüfen – und sich nicht nur auf einen Satz verlassen, den Sie auf der Preisseite des Anbieters gelesen haben.
Was ist ein privater KI-Server?
Ein privater KI-Server ist ein Rechner, den Sie oder Ihr Team selbst verwalten und auf dem die Verarbeitung Ihrer KI-Anfragen stattfindet. Das kann ein Server in Ihren eigenen Räumlichkeiten, eine virtuelle private Cloud (VPC) oder ein vollständig vom Internet getrenntes Netzwerk sein.
Es handelt sich dabei um eine Art der Bereitstellung, nicht um einen Markennamen. Im Jahr 2026 besteht eine typische technische Umgebung aus einer Laufzeitumgebung wie Ollama oder vLLM, häufig ergänzt durch Open WebUI als Benutzeroberfläche. Der Zugriff ist dabei auf ein privates Netzwerk beschränkt.
Ein quantisiertes Modell mit 7 bis 8 Milliarden Parametern lässt sich bereits mit etwa 16 GB Arbeitsspeicher betreiben. Binden Sie denselben Dienst allerdings versehentlich an das öffentliche Internet, haben Sie unbeabsichtigt eine öffentlich zugängliche API eingerichtet.
Private KI vs. ChatGPT
Beim Vergleich von privater KI mit ChatGPT geht es nicht um Open Source gegen OpenAI. Entscheidend ist vielmehr, ob ein Drittanbieter Ihre Prompts zu sehen bekommt.
Die Verbraucherversion von ChatGPT übermittelt Ihre Eingaben vom eigenen Gerät an externe Server. Der Betreiber kann sie während der Inferenz lesen. Ob die Daten zum Training verwendet werden, hängt vom jeweiligen Tarif und den Einstellungen ab. Dennoch können Daten im Rahmen von Sicherheitsüberprüfungen und gesetzlichen Verfahren gespeichert und eingesehen werden.
Bei Enterprise- und API-Angeboten ist das KI-Training mit Kundendaten häufig standardmäßig deaktiviert. Ihre Eingaben befinden sich aber weiterhin auf den Servern des Anbieters – sofern Sie keine vertraglich vereinbarte Isolierung oder Lösung für vertrauliche Datenverarbeitung nutzen.
Private KI-Software und -Plattformen
Private KI-Software bezeichnet die Anwendungsebene, also Programme wie LM Studio, Jan, Ollama oder Open WebUI.
Eine private KI-Plattform bezieht sich dagegen auf das, was Unternehmen darunter verstehen: Daten, Zugriffskontrolle, Training oder Feinabstimmung (Fine-Tuning) sowie die Inferenz innerhalb einer gemeinsamen Sicherheitsgrenze.
Verwechseln Sie diese beiden Kategorien bei der Auswahl jedoch nicht.
Suchen Sie nicht nach der „besten“ privaten KI. Suchen Sie nach der Lösung, deren Schutzmaßnahmen zur Sensibilität der Texte passen, die Sie einsenden möchten.
| Ihr Ziel | Ebene | Beispiel |
|---|---|---|
| Keine Daten sollen das eigene Gerät verlassen | Lokal | LM Studio, Ollama, Januar |
| Gespeicherte Chats sollen für den Anbieter nicht wieder lesbar sein | Speicherung ohne Anbieterzugriff (Zero-Access-Speicher) | Lumo |
| Ein Browser-Assistent ohne Konto und ohne Speicherung der Chats | Hosting ohne Datenspeicherung | Brave Leo AI, Duck.ai |
| Gehostete KI-Inferenz, deren Sicherheitsmaßnahmen Sie überprüfen können | Vertrauliches Hosting | Venice AI TEE/E2EE |
| Zentrale Kontrolle im gesamten Unternehmen | Plattform / eigener Serverbetrieb | VPC oder lokale Serverinfrastruktur |
Brave Leo bietet im Vergleich zu ChatGPT einen höheren Datenschutz: Der Dienst nutzt einen Reverse-Proxy, erfordert kein Benutzerkonto, speichert Unterhaltungen nicht auf den Servern von Brave und verwendet sie nicht zum KI-Training. Die Standardversion von Leo verarbeitet Ihre Prompts allerdings weiterhin auf externen Servern.
Lumo verschlüsselt den gespeicherten Chatverlauf so, dass Proton ihn nicht wieder öffnen kann. Der KI-Server muss den aktuellen Prompt jedoch entschlüsseln, um eine Antwort zu erzeugen.
Venice verwendet im standardmäßigen privaten Modus Hosting ohne Datenspeicherung. Die erweiterten Modi bieten zusätzlich eine hardwarebasierte Isolierung.
Keiner dieser drei Dienste ist jedoch mit Ollama vergleichbar, das direkt auf Ihrem eigenen Rechner ausgeführt wird.
Wenn Sie diese Unterschiede genauer verstehen möchten, lesen Sie unseren Leitfaden darüber, wie Sie überprüfen können, ob ein privater KI-Assistent Ihren Datenschutzanforderungen gerecht wird.
Private KI für Unternehmen
Private KI für Unternehmen bedeutet im Grunde dasselbe wie private KI für den persönlichen Gebrauch – allerdings mit zusätzlichen Anforderungen an Beschaffung, Sicherheit und Compliance.
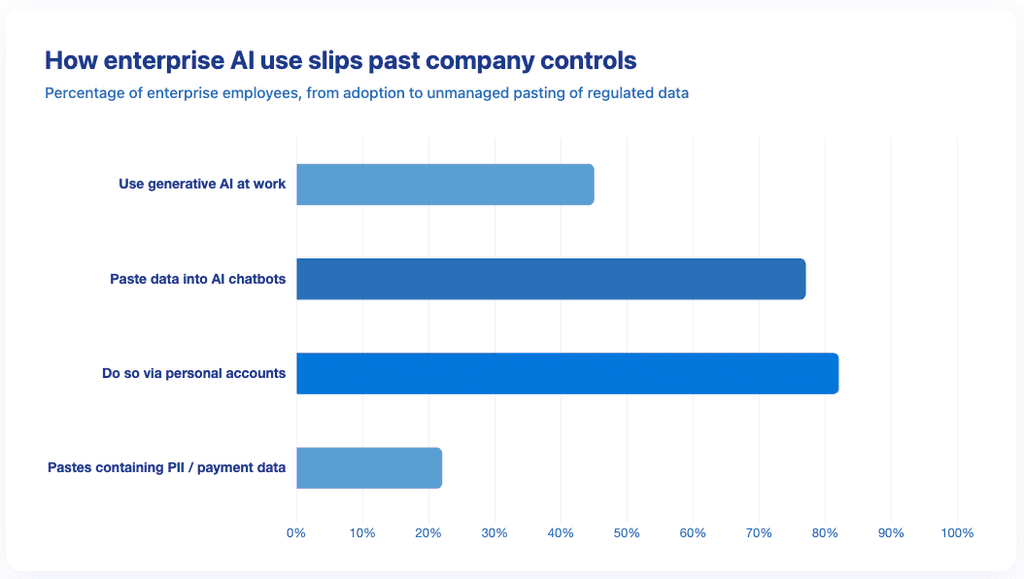
Teams aus den Bereichen Finanzen, Gesundheitswesen, Recht und öffentliche Verwaltung können einen gewöhnlichen Chatbot nicht wie einen Aktenschrank für Kundendaten oder unveröffentlichte Dokumente behandeln. Wie groß das Risiko bereits ist, zeigen die Zahlen: Laut dem Enterprise AI and SaaS Data Security Report 2025 von LayerX nutzen inzwischen 45 % der Beschäftigten generative KI bei der Arbeit. 77 % dieser Nutzer fügen Daten in Chatbots ein. Bei 82 % dieser Eingaben kommen persönliche, nicht verwaltete Konten zum Einsatz, die für die IT-Abteilung unsichtbar bleiben.
Dasselbe Problem betrifft auch die Postfächer, auf die diese KI-Werkzeuge zugreifen: Wenn Ihre E-Mails bereits bei einem Anbieter liegen, der sie zu Werbezwecken scannt, kann auch die nachgelagerte KI-Richtlinie diese Offenlegung nicht rückgängig machen.
Ein privates KI-System, das vollständig vor Ort betrieben wird, hält Modellgewichte, Dokumente und Inferenz innerhalb Ihres Unternehmensgebäudes oder Rechenzentrums.
Eine private KI-Plattform kann stattdessen in einer privaten Cloud betrieben werden, die Sie selbst verwalten. Eine eingeschränkte API ist die einfachste Möglichkeit, bietet aber von diesen drei Varianten den geringsten Datenschutz.
| Bereitstellung | Speicherort der Daten | Kontrolle | Nachteil |
|---|---|---|---|
| Vor Ort (On-Premises) | Eigenes Gebäude oder Rechenzentrum | Am höchsten | Kosten und Wartungsaufwand |
| Private Cloud (VPC) | Isolierte Cloud-Umgebung | Hoch | Sie sind weiterhin vom Cloud-Anbieter abhängig |
| Eingeschränkte API | Beim Anbieter, vertraglich geregelt | Geringer | Schnellste Einrichtung |
Wenn das offiziell freigegebene KI-Werkzeug langsamer ist als ChatGPT, werden Mitarbeiter stillschweigend auf ChatGPT ausweichen. Genau diese heimliche Umgehung interner Vorgaben bezeichnet man als Schatten-KI (Shadow AI) und bezieht sich auf die unkontrollierte, nicht autorisierte Nutzung von KI.
Warum private KI wichtiger ist als die Aussage „Wir trainieren nicht mit Ihren Daten“
Die meisten Übersichten über private KI konzentrieren sich ausschließlich auf das Thema Training. Doch das Training ist nur eine von mehreren Fragen. Ebenso wichtig sind der Zugriff auf Ihre Daten und deren Speicherung.
Ihr KI-Assistent erstellt ein Profil von Ihnen
ChatGPT und ähnliche Werkzeuge begannen als einfache Eingabefelder, in die Sie Ihre Fragen eintippen konnten. Mittlerweile haben sie sich zu Assistenten entwickelt, die Informationen über mehrere Sitzungen hinweg speichern und sich an frühere Unterhaltungen erinnern.
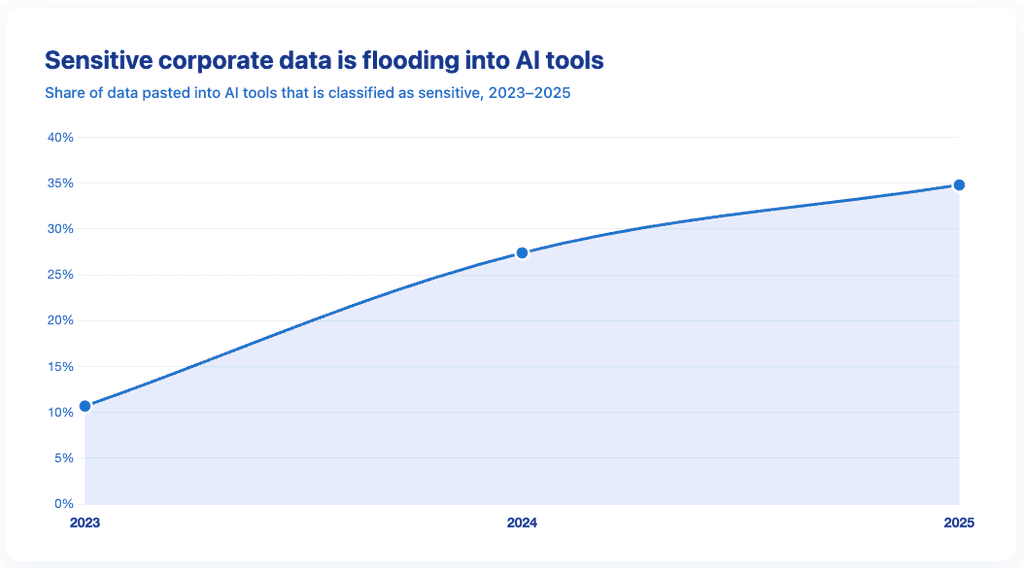
Aus diesen Erinnerungen entsteht nach und nach ein persönliches Profil: Ihre Gesundheit, Ihre Arbeit, Ihre finanzielle Situation, Ihre Beziehungen und sogar die Art, wie Sie schreiben, wenn Sie müde sind. Und die Informationen, aus denen dieses Profil entsteht, werden immer sensibler. Laut dem AI Adoption and Risk Report von Cyberhaven 2025 hat sich der Anteil der als sensibel eingestuften Unternehmensdaten, die in KI-Werkzeuge eingegeben werden, innerhalb von zwei Jahren mehr als verdreifacht: von 10,7 % im Jahr 2023 auf 34,8 % im Jahr 2025.
Ein persönlicher KI-Agent geht noch einen Schritt weiter. Er beantwortet nicht nur Fragen, sondern führt auch Aktionen aus: beispielsweise mit Dateien, über einen Browser oder mithilfe gespeicherter Zugangsdaten. Und es gibt jemanden, der dieses Profil und die damit verbundenen Zugriffsmöglichkeiten verwaltet. Die entscheidende Frage lautet: Wer ist das?
„Privat“ ist für die einen eine Richtlinie, für die anderen eine Architektur
Eine Formulierung in einer Datenschutzerklärung lässt sich ändern. Ein lokal ausgeführter Prozess hingegen nicht. Hardwarebasierte Isolierung in Verbindung mit einer Attestierung soll überprüfbar sein. Ein Marketingversprechen ist es nicht.
Hier zeigt sich erneut der Unterschied zwischen den beiden Betriebsmodellen. Variante 1 basiert auf Physik: Ihre Daten bleiben auf Ihrer eigenen Hardware. Variante 2 basiert auf einer Reihe von Aussagen.
Prüfen Sie deshalb das tatsächliche Schutzniveau und verlassen Sie sich nicht allein auf die Bezeichnung eines Dienstes.
„Privat“ ist nicht gleich „anonym“
Selbst wenn ein Anbieter Ihre Prompts nicht lesen kann, hinterlässt Ihre Nutzung weiterhin Spuren: wann Sie eine Anfrage stellen, wie häufig Sie den Dienst verwenden, welches Gerät und welchen Browser Sie nutzen und welchen Schreibstil Sie haben. Auch Ihre Eingaben selbst können Rückschlüsse auf Ihre Identität ermöglichen, denn viele Menschen teilen ihrem KI-Assistenten persönliche Informationen mit.
Datenschutz im klassischen Sinne bedeutet: Andere können erkennen, wer Sie sind, aber nicht, was Sie tun. Anonymität bedeutet das Gegenteil. – Öffentliche KI-Dienste bieten häufig weder das eine noch das andere in vollem Umfang.
Das Versagen ist nicht nur theoretischer Natur: Mitte 2025 wurden rund 4.500 öffentlich geteilte ChatGPT-Unterhaltungen von Google indexiert. Einige davon enthielten Namen, Lebensläufe und sensible persönliche Informationen. Möglich wurde dies durch eine optionale Einstellung mit der Bezeichnung „Make discoverable“ (auffindbar machen). OpenAI deaktivierte diese Funktion im August desselben Jahres.
Einige gehostete Dienste verbessern die Anonymität durch Funktionen wie die Nutzung ohne Benutzerkonto, Proxy-Verbindungen oder nicht zuordenbare Zahlungsprozesse. Trotzdem können sie weiterhin Ihre aktuelle Eingabe während der Verarbeitung lesen. Eine lokal ausgeführte KI schützt Ihre Eingaben vor externen Anbietern, verhindert aber nicht, dass jemand auf die Daten eines beschlagnahmten Laptops zugreifen kann.
Metadaten und Geräte-Fingerprinting verschwinden nicht allein deshalb, weil auf der Startseite eines Dienstes das Wort „privat“ steht.
Wenn ein persönlicher KI-Assistent Ihren Posteingang erreichen kann
Die neuesten KI-Agenten beschränken sich nicht mehr auf ein Chatfenster. Sie formulieren Antworten, lesen E-Mail-Verläufe, greifen auf Kalender zu und verfügen über die erforderlichen Zugriffstoken, um diese Aufgaben auszuführen. Damit erstreckt sich der Datenschutz des Assistenten unmittelbar auf den Datenschutz aller Konten, auf die er zugreifen kann.
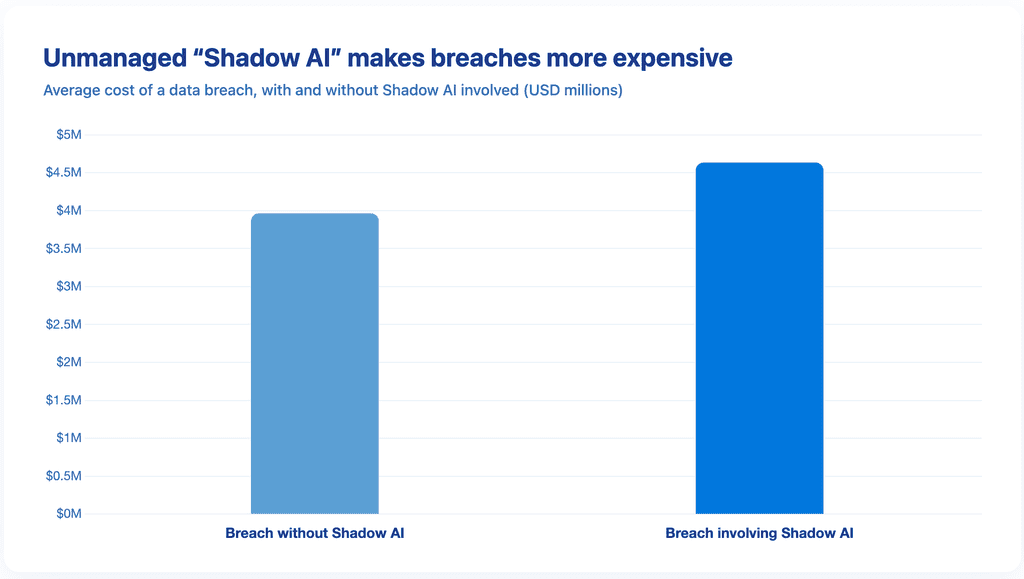
Wenn Ihr E-Mail-Postfach bereits zu Werbezwecken oder für das KI-Training analysiert wird, vergrößert ein KI-Agent ein bereits bestehendes Sicherheitsrisiko. Die Folgen dieses Risikos lassen sich beziffern: Laut der IBM-Studie Cost of a Data Breach 2025 berichtete jedes fünfte Unternehmen von einem Datenschutzvorfall im Zusammenhang mit Shadow AI.
Unternehmen mit einer weitverbreiteten Shadow-AI-Nutzung verzeichneten durchschnittlich rund 670.000 US-Dollar höhere Kosten pro Datenschutzvorfall als Unternehmen mit geringer oder keiner Shadow-AI-Nutzung. Gleichzeitig verfügten 97 % der Unternehmen, die einen KI-bezogenen Sicherheitsvorfall erlebten, über keine angemessenen KI-Zugriffskontrollen.
Bei verschlüsselten E-Mails sind Nachrichten nicht automatisch geschützt, nachdem ein KI-Agent sie entschlüsselt hat und berechtigt ist, ihren Inhalt an ein externes Modell zu übermitteln. Die Verschlüsselung schützt eine Nachricht, solange sie sich innerhalb des verschlüsselten Systems befindet. Sie kann jedoch nicht kontrollieren, was eine vertrauenswürdige Anwendung mit dem Klartext macht, nachdem sie rechtmäßigen Zugriff darauf erhalten hat.
Mailfence ist kein privates KI-Produkt. Was Mailfence vielmehr bietet, ist einen geschützter Ort für die E-Mails und Dateien, die Ihre KI-Agenten nicht ungeschützt an eine öffentliche GPU übermitteln sollten: Ende-zu-Ende-Verschlüsselung, die Sie selbst kontrollieren, Hosting in Belgien, keine Werbung und keine verdeckten Absichten.
Der KI-Assistent und Ihr Postfach fallen in die selbe Sicherheitsgrenze. Behandeln Sie sie dementsprechend.
„Die Menschen fragen immer wieder, ob eine KI mit ihren Daten trainiert. Das ist jedoch nicht die erste Frage, die Sie stellen sollten. Fragen Sie stattdessen, wer Ihre Prompts lesen kann, während das Modell eine Antwort erstellt, und wem das anschließend gespeicherte Profil gehört. Wenn Sie nicht benennen können, auf welchem Gerät Ihre Daten verarbeitet werden, haben Sie keine echte Privatsphäre.“ – Patrick De Schutter, Mitbegründer von Mailfence
So wählen Sie die richtige private KI aus
Beginnen Sie mit einer einfachen Frage: Wie sensibel sind die Informationen, die Sie übermitteln möchten? Wählen Sie anschließend ein Tool, dessen Schutzniveau zu Ihrer Antwort passt.
- Persönliche Notizen und alltägliche Texte auf Ihrem eigenen Laptop → betreiben Sie eine lokale Anwendung wie Jan, LM Studio oder Ollama. Ihre Daten verlassen das Gerät nicht.
- KI für Ihren gesamten Haushalt oder ein kleines Team, jederzeit verfügbar → richten Sie einen eigenen privaten KI-Server ein.
- Schnelle Fragen über die Seitenleiste Ihres Browsers, mit einem Anbieter, der Ihre Unterhaltungen nicht speichert → Brave Leo AI.
- Ein Chatverlauf, den selbst der Anbieter nicht wieder öffnen kann → Lumo.
- Cloud-KI mit hardwarebasiertem Nachweis, dass Ihre Daten während der Verarbeitung abgeschirmt sind → Venice AI.
- Daten, die aus rechtlichen oder vertraglichen Gründen Ihre Räumlichkeiten nicht verlassen dürfen → On-Premises-Lösung.
- Die leistungsfähigste Antwort und keinerlei persönliche Daten im Spiel → ChatGPT. Achten Sie jedoch darauf, welches Datenschutzniveau diese Lösung tatsächlich bietet.
Sie möchten Large Language Models (LLMs) lokal betreiben? Harish erklärt hier, wie Sie dabei vorgehen und welche Vorteile das für Ihren Datenschutz hat:
Unabhängig davon, für welche Lösung Sie sich entscheiden, sollten Sie vor jeder Übermittlung die folgende Checkliste durchgehen:
- Würde ich diesen Text auch einer fremden Person in diesem Unternehmen anvertrauen?
- Ist die deaktivierte Trainingsfunktion tatsächlich der Schutz, den ich benötige, oder nur der erste Schritt?
- Könnte ich diese Aufgabe stattdessen auf meinem eigenen Gerät erledigen?
- Habe ich die Informationen selbst eingefügt oder wurden sie durch eine Erweiterung oder ein Plug-in übermittelt?
- Kann ich genau benennen, auf welchem Gerät meine Eingaben verarbeitet werden?
Die wichtigsten Erkenntnisse
- Private KI bedeutet eine klar definierte Sicherheitsgrenze und nicht nur eine deaktivierte Trainingsfunktion.
- Es gibt zwei Möglichkeiten: Sie betreiben das Modell selbst oder nutzen einen externen Anbieter. Die Anbieter unterscheiden sich hinsichtlich ihres Datenschutzniveaus.
- Dass Ihre Daten nicht zum Training verwendet werden, bedeutet nicht, dass sie niemand lesen kann.
- Die Verschlüsselung Ihres gespeicherten Chatverlaufs bedeutet nicht automatisch, dass Ihre aktuellen Eingaben während der Verarbeitung geschützt sind.
- Ein gewöhnlicher Chatbot mit deaktiviertem Training bietet die schwächste Form privater KI.
- Das persönliche Profil, das Ihr KI-Assistent erstellt, gehört ebenso zu Ihrer Datenschutzentscheidung wie die Eingabe, die Sie gerade übermitteln.
Abschließende Gedanken
Private KI bedeutet eine klar definierte Sicherheitsgrenze. Von Unternehmen betriebene KI-Dienste können datenschutzfreundlicher als ChatGPT sein, ohne dass sie lokal ausgeführt werden. Auch lokal betriebene Anwendungen können Daten über Plug-ins, offene Netzwerkports oder ein entwendetes Speichermedium preisgeben.
Entscheidend sind zwei Fragen: Wer kann Ihre Prompts sehen und wem gehören die gespeicherten Informationen über Sie? Alles andere ist Marketing.
Wenn Ihr KI-Assistent künftig auf Ihre E-Mails oder Dateien zugreifen soll, beginnen Sie mit einem Postfach, dessen Inhalte nicht bereits zum Datenbestand eines fremden Anbieters gehören: Erstellen Sie ein Mailfence-Konto.
Privatsphäre ist ein Recht und keine Zusatzfunktion. Das gilt auch für den Absatz, den Sie gerade in einen KI-Assistenten einfügen wollten.
Glossar
Attestierung (Attestation) – Ein kryptografischer Nachweis, dass eine Umgebung für vertrauliche Datenverarbeitung tatsächlich den zugesicherten Sicherheitsanforderungen entspricht. So können Sie die Isolierung überprüfen, statt sich auf eine Aussage auf einer Preisseite verlassen zu müssen.
Sicherheitsgrenze (Boundary) – Der klar definierte Schutzbereich, auf den sich dieser Leitfaden bezieht: das Gerät, der Server oder das Konto, innerhalb dessen Ihre Daten und die Verarbeitung Ihrer Anfrage verbleiben.
Vertrauliche Datenverarbeitung (Confidential Computing) – Eine Technologie, bei der Hardware Daten innerhalb einer isolierten Sicherheitsumgebung verarbeitet. Dadurch soll selbst der Betreiber des Computers während der Verarbeitung keinen Zugriff auf die Daten haben.
Daten während der Verarbeitung (Data in Use) – Der Zeitraum, in dem Informationen im Arbeitsspeicher entschlüsselt vorliegen, damit sie verarbeitet werden können. Die Verschlüsselung während der Übertragung und die Verschlüsselung gespeicherter Daten im Ruhezustand schließen diese Sicherheitslücke nicht. Bei privater KI geht es wesentlich darum, wer diesen Verarbeitungsschritt kontrolliert.
Föderiertes Lernen (Federated Learning) – Eine Trainingsmethode, bei der mehrere Geräte gemeinsam ein Modell verbessern, ohne ihre ursprünglichen Daten zentral zusammenzuführen. Ihr Smartphone trainiert beispielsweise eine eigene Modellkopie und übermittelt lediglich kleine Aktualisierungen statt Ihrer Nachrichten.
Homomorphe Verschlüsselung (Homomorphic Encryption) – Ein Verschlüsselungsverfahren, das Berechnungen direkt auf verschlüsselten Daten ermöglicht. Dadurch kann ein Computer Ergebnisse erzeugen, ohne jemals den ursprünglichen Klartext zu sehen. In der Theorie ist diese Technologie sehr leistungsfähig, für KI-Chatbots im Alltag jedoch noch zu langsam.
Inferenz (Inference) – Der Verarbeitungsschritt, bei dem ein trainiertes Modell aus Ihrer Eingabe eine Antwort erstellt. Dabei werden Ihre Informationen tatsächlich verarbeitet. Genau hier entscheidet sich, ob Ihre Daten geschützt bleiben.
Schatten-KI (Shadow AI) – Die nicht genehmigte Nutzung öffentlicher KI-Tools für berufliche Zwecke außerhalb der geltenden Unternehmensrichtlinien oder ohne Kontrolle durch die IT-Abteilung. Sie ist einer der wesentlichen Wege, über die sensible Unternehmensdaten in KI-Systeme gelangen, die die Organisation nie freigegeben hat.
Sichere Mehrparteienberechnung (Secure Multi-Party Computation) – Eine Gruppe kryptografischer Verfahren, mit denen mehrere Beteiligte gemeinsam ein Ergebnis berechnen können, ohne ihre jeweiligen Eingabedaten offenzulegen. Niemand verfügt über sämtliche Informationen; nur das vereinbarte Ergebnis wird freigegeben.
TEE (Trusted Execution Environment) – Ein hardwarebasierter, isolierter Bereich eines Prozessors, in dem Code und Daten während der Verarbeitung vor dem restlichen System abgeschirmt werden sollen. Dies gilt auch für den Betreiber der Hardware. TEE ist eine zentrale technische Grundlage vieler Lösungen für vertrauliche Datenverarbeitung.
Modellgewichte (Weights) – Die trainierten Parameter, aus denen ein KI-Modell besteht. Als „Open Weights“ bezeichnet man Modellgewichte, die Sie herunterladen und auf Ihrem eigenen Gerät ausführen können, beispielsweise bei Llama, Mistral oder Gemma.
Zero Access – Eine Speicherlösung, bei der Daten so verschlüsselt werden, dass der Anbieter keinen Schlüssel besitzt, um sie zu lesen. Ihr gespeicherter Chatverlauf befindet sich weiterhin auf den Servern des Anbieters, kann von diesem jedoch nicht erneut entschlüsselt werden.
FAQ rund um Private KI
Ist private KI datenschutzfreundlicher als ChatGPT?
Ja, sofern Sie eine Lösung wählen, die ein höheres Datenschutzniveau als die standardmäßige Consumer-Version von ChatGPT bietet. ChatGPT überzeugt durch seine Leistungsfähigkeit. Private KI bietet Ihnen dagegen mehr Kontrolle über Ihre Prompts.
Kann ich eine private KI betreiben, ohne über technische Kenntnisse zu verfügen?
Ja, zumindest auf der Ebene lokaler Anwendungen. Installieren Sie LM Studio oder Jan, wählen Sie ein kleines quantisiertes Modell aus und deaktivieren Sie die automatische Nutzung externer Cloud-Dienste.
Welche private KI eignet sich am besten für den persönlichen Gebrauch?
Das hängt davon ab, welche Informationen Sie verarbeiten möchten. Eine lokale Lösung ist sinnvoll, wenn Ihre Daten das Gerät nicht verlassen dürfen. Lumo eignet sich, wenn Ihnen der Schutz gespeicherter Unterhaltungen besonders wichtig ist. Brave Leo ist eine Option, wenn Sie einen Browser-Assistenten ohne Benutzerkonto nutzen möchten. Eine einzige Lösung, die für alle Anwendungsfälle die beste ist, gibt es nicht.
Sind Lumo, Brave Leo oder Venice AI Beispiele für private KI?
Ja. Alle drei Dienste gehören zu den gehosteten Lösungen für private KI. Lumo speichert Ihren Chatverlauf in einem Zero-Access-Speicher. Brave Leo kombiniert die Verarbeitung ohne dauerhafte Speicherung mit einem Proxyserver zwischen Ihnen und dem KI-Modell. Venice speichert standardmäßig keine Daten dauerhaft. Erweiterte Modi bieten zusätzlichen Schutz durch TEE und E2EE. Beachten Sie jedoch: Keiner dieser Dienste arbeitet lokal, solange Sie ihn nicht mit einem Modell verbinden, das auf Ihrem eigenen Gerät ausgeführt wird.
Kann private KI vollständig vor Ort betrieben werden?
Ja. Dabei bleiben Modellgewichte, Dokumente und die Verarbeitung Ihrer Anfragen innerhalb Ihrer eigenen Räumlichkeiten. Dies ist die Variante mit dem höchsten Maß an Kontrolle für Unternehmen.
Ist ein persönlicher KI-Agent automatisch eine private KI?
Nur dann, wenn sämtliche Bestandteile des Systems entsprechend geschützt sind. Ein persönlicher KI-Agent ist mehr als ein KI-Modell. Er handelt in Ihrem Auftrag: Er liest Ihre Dateien, durchsucht das Internet und verwendet unter Umständen Ihre Passwörter oder Zugangsdaten. Jede dieser Aktionen kann dazu führen, dass Ihre Daten Ihr Gerät verlassen. Deshalb ist ein KI-Agent nur so privat wie das am wenigsten geschützte Tool, auf das er zugreift. Ein lokal betriebenes Modell schützt Sie beispielsweise nicht, wenn eines seiner Plug-ins Ihre Texte unbemerkt an einen fremden Server übermittelt.
Reicht die Aussage „Wir trainieren nicht mit Ihren Daten“ für private KI aus?
Nein. Training, Speicherung und Zugriff während der Verarbeitung sind drei unterschiedliche Themen. Ein Anbieter kann darauf verzichten, Ihre Daten zum Trainieren seiner Modelle zu verwenden, und trotzdem jeden einzelnen Ihrer Prompts lesen.