Il s’agit d’un périmètre de sécurité que vous pouvez définir : le modèle fonctionne sur une machine que vous contrôlez ou sur un serveur conçu de manière à empêcher, en principe, les opérateurs d’accéder à vos requêtes. La plupart des pages se contentent d’indiquer : « Nous n’entraînons pas le modèle à partir de vos données. » C’est un point important, mais ce n’est pas tout.
Ce guide explique ce qu’est l’IA privée, comment fonctionnent les modèles d’IA privés et l’inférence privée, quelles sont les deux principales options de déploiement, quels niveaux de confidentialité propose l’hébergement externe et pourquoi la simple promesse « nous n’entraînons pas le modèle sur vos données » ne suffit pas.
💡 L’IA privée repose sur un périmètre de sécurité que vous pouvez définir vous-même, et non sur un simple paramètre d’un service tiers.
En bref
- Une IA privée est un système dans lequel le modèle, vos données et le processus de génération des réponses restent à l’intérieur d’un périmètre de sécurité clairement défini.
- La machine sur laquelle le modèle s’exécute doit pouvoir accéder au texte pendant son traitement. La question est de savoir à qui appartient cette machine et si d’autres personnes peuvent y avoir accès.
- Deux options s’offrent à vous : gérer vous-même votre infrastructure (ou votre propre matériel) ou faire appel à un hébergeur. Tous les hébergeurs ne se valent pas.
- Désactiver l’entraînement dans ChatGPT n’est qu’un minimum, et non un objectif en soi.
Qu’est-ce que l’IA privée ?
On parle d’IA privée lorsqu’un système garantit que le modèle, vos documents et le processus de génération des réponses restent à l’intérieur d’un périmètre de sécurité que vous pouvez définir.
Les requêtes ne sont pas systématiquement transmises à une API publique. Elles ne servent pas à entraîner le modèle d’un tiers, soit parce qu’elles n’y parviennent pas, soit parce que la conception de l’hébergeur rend cette utilisation impossible à dissimuler derrière un simple bouton.
L’IA publique, quant à elle, fonctionne à l’inverse. Vous envoyez du texte à un prestataire externe. Ce dernier peut le lire pendant que le modèle s’exécute. Il peut l’enregistrer, le conserver ou l’utiliser pour l’entraînement du modèle.
Déplacez le calcul vers les données, plutôt que l’inverse.
IA privée : le modèle, vos données et l’étape de génération de réponse restent confinés dans un périmètre que vous pouvez délimiter. La machine qui exécute le modèle doit avoir accès au texte pendant son fonctionnement. Ce périmètre est appelé « données en cours d’utilisation ». Le chiffrement en transit et le chiffrement au repos ne s’y appliquent pas. Ce qui fait la différence, c’est de savoir à qui appartient la machine, et si quelqu’un d’autre peut lire le texte ou l’utiliser pour l’entraînement.
C’est là le sens architectural du terme. Deux autres utilisations de cette même expression circulent. Les chercheurs parlent également d’IA privée pour désigner des méthodes cryptographiques – chiffrement homomorphe, calcul multipartite sécurisé, apprentissage fédéré – qui visent à effectuer des calculs sur des données que personne d’autre ne voit en clair. Ces utilisations sont bien réelles. Elles ne correspondent pas à la manière dont la plupart des gens interagissent avec un grand modèle de langage en 2026. Les experts marketing emploient également l’expression « IA privée » pour désigner un chatbot hébergé dont la fonction d’entraînement a été désactivée. Considérez cela comme une affirmation. Il ne s’agit pas d’une limite.
L’IA privée ne correspond pas non plus aux « paramètres de confidentialité de l’IA ». Les paramètres de confidentialité dépendent du service fourni par un tiers. L’architecture, quant à elle, détermine où le modèle s’exécute et où les données sont traitées.
Deux méthodes pour exploiter une IA en mode privé
- Vous gérez vous-même le système, qu’il soit installé sur un ordinateur portable, un téléphone, un serveur d’IA privé ou une machine isolée du réseau. Les données ne quittent pas votre infrastructure, sauf si vous exposez un service sur un port public, installez un module complémentaire ou utilisez une clé API vers un service externe.
- Vous confiez la gestion du système à un hébergeur. Vous lui transmettez vos requêtes et vous vous fiez aux garanties qu’il propose : engagements contractuels, processus sans conservation des données, stockage des conversations auquel le fournisseur ne peut pas accéder ou matériel assurant l’isolation du traitement.
La deuxième option ne correspond pas à un produit unique. Elle recouvre plusieurs types de garanties, dont le niveau de protection varie.
Les différents niveaux de confidentialité de l’IA privée
| Niveau | Qui peut consulter la requête pendant son traitement ? | Quelles garanties protègent les données ? | Exemple |
|---|---|---|---|
| Local / hébergé en interne | Les personnes ayant accès à la machine | Contrôle de l’infrastructure. Le modèle s’exécute sur un matériel que vous contrôlez, sans recours nécessaire à un fournisseur externe pour l’inférence. | Ollama, LM Studio |
| Hébergement confidentiel | L’opérateur du service ne devrait pas pouvoir consulter la requête, même pendant son traitement. | Isolation matérielle. Le matériel de confiance isole le modèle et les données ; l’attestation vous permet de vérifier que le code approuvé est bien en cours d’exécution. | Venice AI en modes TEE / E2EE ; architectures de type « Apple Private Cloud Compute » |
| Stockage « zéro accès » | L’hébergeur (ou le fournisseur) peut lire la requête tout en répondant, mais ne doit pas pouvoir récupérer les conversations enregistrées par la suite. | Les conversations enregistrées sont chiffrées ; le fournisseur ne peut donc ni les déchiffrer ni les consulter ultérieurement | Lumo |
| Hébergeur sans conservation des données | L’hébergeur peut lire la question tout en y répondant et peut la traiter ou l’enregistrer temporairement. | Politique et processus. Le prestataire affirme supprimer les données après leur traitement et ne pas les utiliser pour l’entraînement des modèles | Brave Leo AI, Duck.ai |
| Service grand public avec entraînement désactivé | L’hébergeur peut lire, enregistrer, consigner, consulter ou divulguer la requête, sous réserve de ses politiques et de ses obligations légales | Un simple interrupteur permet de désactiver l’utilisation systématique des données pour l’entraînement des modèles, mais il n’empêche pas le fournisseur d’y accéder pendant le fonctionnement du service. | ChatGPT ou Claude, avec l’utilisation des données pour l’entraînement désactivée. |
Si vous ne pouvez pas identifier la machine qui reçoit vos requêtes, vous devez considérer la confidentialité comme une promesse du fournisseur, et non comme une garantie découlant de l’architecture du système.
Comment fonctionne l’IA privée ?
Commençons par une explication simplifiée. Vous chargez un modèle. Vous posez une question. Le modèle répond. La confidentialité dépend des mesures de protection appliquées pendant le traitement, tandis que la requête est conservée temporairement en mémoire sur la machine qui effectue les calculs.
Qu’est-ce qu’un modèle d’IA privé ?
Un modèle d’IA privé correspond généralement à l’une des trois catégories suivantes, que l’on a tendance à confondre :
- Modèles à poids ouverts que vous pouvez télécharger et conserver : Llama, Mistral, Gemma, Qwen et les modèles de la famille Phi.
- Un modèle fournisseur déployé dans votre cloud privé ou votre centre de données
- Un modèle hébergé dont vous ne serez jamais propriétaire
Le fait de télécharger et de conserver les poids du modèle ne suffit pas, à lui seul, à protéger vos requêtes. Dès lors que vous mettez le modèle à disposition via un point de terminaison public, celui-ci peut être accessible à tous, même si vous êtes propriétaire des fichiers.
Qu’est-ce que l’inférence privée en IA ?
En intelligence artificielle, on parle d’inférence lorsque, à partir de nouvelles données d’entrée, un modèle entraîné produit une sortie, telle qu’une réponse, une prédiction, une classification ou une image générée.
L’inférence privée est le processus par lequel un modèle traite une requête et produit une réponse sans que le texte en clair soit exposé en dehors du périmètre de sécurité que vous avez défini.
Lors du traitement d’une requête par une API publique, le texte en clair peut être présent dans la mémoire du système du fournisseur, notamment dans la mémoire du GPU. Un fournisseur qui ne conserve pas les données peut néanmoins y accéder pendant leur traitement. Le stockage à accès nul chiffre l’historique des conversations après leur enregistrement ; le serveur doit néanmoins pouvoir déchiffrer la requête pour générer une réponse.
Un environnement d’exécution de confiance (TEE) tente de confiner cet instant au sein d’une enclave matérielle que l’opérateur ne peut inspecter, mais vous devez vérifier l’attestation, et pas seulement une phrase figurant sur une page de tarifs.
Qu’est-ce qu’un serveur d’IA privé ?
Un serveur d’IA privé est la machine que vous (ou votre équipe) administrez et sur laquelle s’exécute cette étape de réponse : un serveur sur site, un VPC ou un réseau isolé. Il s’agit d’un déploiement, et non d’un nom de marque. En 2026, une configuration courante repose sur un environnement d’exécution tel qu’Ollama ou vLLM, souvent associé à Open WebUI comme interface, le tout étant connecté à un réseau privé.
Un modèle quantifié de taille 7 à 8 milliards de paramètres, suffisamment performant, tient dans environ 16 Go de mémoire vive. Que se passe-t-il si vous connectez ce même service à Internet et exposez accidentellement son API au public ?
IA privée ou ChatGPT : quelles différences ?
La différence entre l’IA privée et ChatGPT ne réside pas dans le fait que l’une soit open source et l’autre non (OpenAI). Il s’agit de savoir si un tiers peut accéder aux jetons de traitement ou aux données transmises au modèle.
Dans la version grand public de ChatGPT, la requête est transmise hors de l’appareil. L’opérateur peut la consulter pendant la phase d’inférence. L’utilisation des données pour l’entraînement peut varier selon l’offre choisie. Certaines données peuvent néanmoins être conservées à des fins de détection des abus ou pour répondre à des obligations légales.
Les niveaux « Entreprise » et « API » sont souvent configurés par défaut sans entraînement. La requête reste toutefois chez le fournisseur, sauf si vous disposez d’un contrat prévoyant une isolation ou un traitement confidentiel des données.
Logiciels et plateformes d’IA privée
Les logiciels d’IA privée constituent la couche applicative du système. Parmi eux figurent LM Studio, Jan, Ollama et Open WebUI. Une plateforme d’IA privée regroupe, au sein d’un même périmètre, les données, le contrôle des accès, l’entraînement ou l’ajustement du modèle, ainsi que l’inférence.
Il importe toutefois de ne pas confondre ces deux catégories.
Ne cherchez pas la « meilleure » IA privée. Cherchez celle dont le niveau de protection correspond au degré de sensibilité réel du texte que vous vous apprêtez à envoyer.
| Votre objectif | Niveau | Exemple |
|---|---|---|
| Aucune donnée ne quitte l’appareil | Local | Aucune donnée ne quitte l’appareil | Local | LM Studio, Ollama, Jan |
| Discussions enregistrées que l’hébergeur ne peut pas rouvrir | Stockage « zéro accès » | Lumo |
| Un assistant intégré au navigateur, sans création de compte et sans conservation des données | Hébergeur sans conservation des données | Brave Leo AI, Duck.ai |
| Inférence hébergée avec des garanties techniques vérifiables. | Hôte confidentiel | Venice AI TEE / E2EE |
| Contrôle à l’échelle de l’entreprise | Plateforme / sur site | VPC ou infrastructure sur site |
Brave Leo est plus confidentiel que ChatGPT : proxy inverse, aucun compte requis, les conversations ne sont pas conservées du côté de Brave et ne sont pas utilisées à des fins d’entraînement. Par défaut, Leo fonctionne toujours en inférence à distance. Lumo crypte l’historique stocké afin que Proton ne puisse pas le rouvrir ; le serveur LLM décrypte toutefois la requête en temps réel pour y répondre. Par défaut, Venice propose un mode d’hébergement sans conservation des données ; ses modes les plus sécurisés ajoutent une isolation matérielle.
Aucun de ces trois services n’est identique à Ollama sur localhost.
L’IA privée au service des entreprises
L’IA privée destinée aux entreprises répond aux mêmes principes, mais soulève aussi des questions de choix des solutions, de déploiement et de gouvernance.
Dans les secteurs de la finance, de la santé, du droit et de l’administration, les équipes ne peuvent pas traiter un chatbot grand public comme un simple espace de stockage pour des dossiers clients ou des documents confidentiels non publiés.
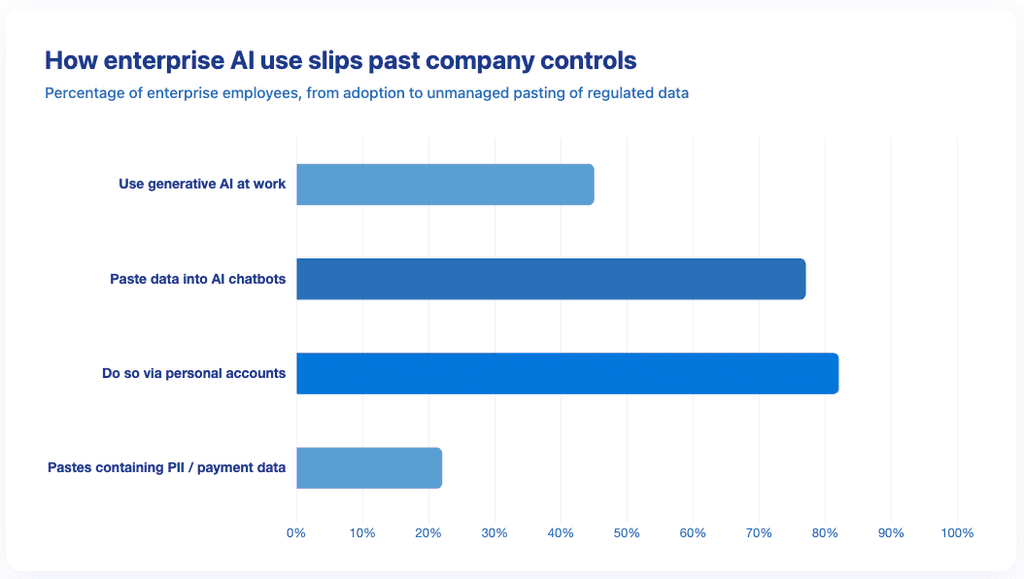
L’ampleur du risque d’exposition des données est déjà documentée. Selon le rapport « Enterprise AI and SaaS Data Security Report 2025 » de LayerX, 45 % des employés d’entreprise utilisent désormais l’IA générative au travail, 77 % de ces utilisateurs collent des données dans des chatbots, et 82 % de ces données proviennent de comptes personnels non gérés que le service informatique ne voit jamais. Le même raisonnement s’applique aux boîtes mail auxquelles ces outils accèdent. Si un message est déjà hébergé chez un prestataire qui l’analyse à des fins publicitaires, aucune politique d’utilisation de l’IA ne peut, à elle seule, empêcher son exposition.
Un système d’IA privé fonctionnant entièrement sur site conserve les poids, les documents et les inférences au sein de vos locaux ou de votre centre de données. Une plateforme d’IA privée peut, quant à elle, être hébergée dans un cloud privé que vous administrez. Une API verrouillée constitue la solution la plus simple, mais aussi la moins confidentielle des trois.
| Déploiement | Localisation des données | Contrôle | Compromis |
|---|---|---|---|
| Sur site | Votre bâtiment ou votre centre de données | Le plus élevé | Coût et entretien |
| Cloud privé (VPC) | Locataire isolé | Élevé | Vous dépendez toujours de l’opérateur de cloud |
| API verrouillée | Prestataire, lié par contrat | Plus bas | Le plus rapide au départ |
Si l’outil officiel est plus lent que ChatGPT, le personnel risque de continuer à utiliser ChatGPT en contournant les règles internes. C’est précisément ce que l’on appelle l’IA fantôme (Shadow AI).
Pourquoi l’IA privée revêt une importance plus grande que le fait de « ne pas entraîner les modèles »
La plupart des analyses consacrées à l’IA privée se limitent à l’apprentissage. L’apprentissage est l’un des enjeux. L’accès et la mémoire en constituent d’autres.
Votre assistant IA est en train de dresser votre profil
Les outils de type ChatGPT ont d’abord été lancés sous la forme de champs de saisie. Ils sont ensuite devenus des assistants dotés d’une mémoire qui perdure d’une session à l’autre. Cette mémoire finit par constituer un profil regroupant des informations sur votre santé, votre travail, vos finances, vos relations et même votre manière d’écrire lorsque vous êtes fatigué.
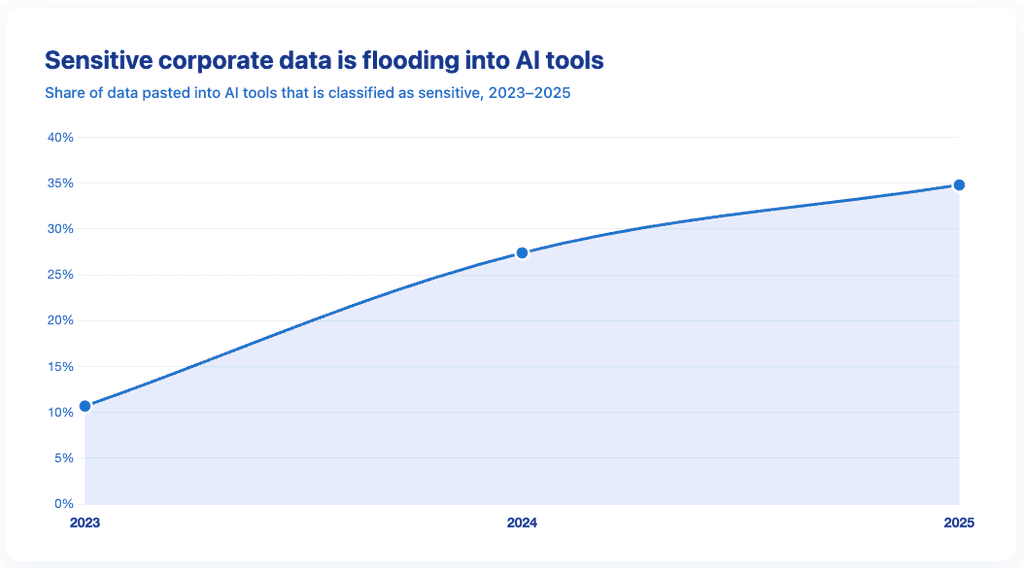
Or, les données utilisées pour établir ce profil deviennent de plus en plus sensibles, et non l’inverse. La part des données d’entreprise saisies dans les outils d’IA et classées comme sensibles a plus que triplé en deux ans, passant de 10,7 % en 2023 à 34,8 % en 2025, selon le rapport « 2025 AI Adoption and Risk Report » de Cyberhaven.
Un agent IA personnel va plus loin. Il ne se contente pas de discuter. Il agit : avec des fichiers, un navigateur, parfois des identifiants. Quelqu’un détient ce profil et ces identifiants. Une IA privée permet à chacun de mieux contrôler l’utilisation de ses données.
Pour certains, la « vie privée » est une ligne de conduite ; pour d’autres, c’est une architecture
Les engagements figurant dans une politique de confidentialité peuvent être modifiés. Une architecture locale, en revanche, repose sur des mécanismes techniques concrets. L’isolation matérielle associée à l’attestation est censée pouvoir être vérifiée ; un slogan, en revanche, ne l’est pas.
On retrouve ici la même dichotomie entre deux voies. La première approche repose sur le contrôle matériel du système. La seconde dépend d’un ensemble d’engagements et de garanties fournis par l’hébergeur. Vérifiez le niveau, ne vous fiez pas à l’étiquette.
« Privé » ne signifie pas « anonyme ».
Même lorsque le contenu de vos requêtes n’est pas accessible à un tiers, certaines informations sur votre utilisation peuvent rester visibles : le moment où vous posez vos questions, leur fréquence, l’appareil et le navigateur utilisés, ainsi que votre style d’écriture. Les questions posées permettent également de vous identifier, car les utilisateurs indiquent aux assistants qui ils sont.
Dans cette distinction, la confidentialité consiste à protéger le contenu de vos activités, tandis que l’anonymat consiste à empêcher que ces activités soient reliées à votre identité. L’IA publique échoue souvent sur ces deux plans. Cet échec n’est pas hypothétique : mi-2025, environ 4 500 conversations partagées sur ChatGPT (dont certaines contenaient des noms, des CV et des informations personnelles sensibles) ont été indexées par Google après l’activation d’un bouton « rendre visible », jusqu’à ce qu’OpenAI désactive cette fonctionnalité en août de la même année. Certains outils hébergés garantissent l’anonymat (pas de compte, un proxy, une facturation non associable) tout en permettant de lire la requête en temps réel. L’inférence locale masque la requête, mais ne dissimule pas un ordinateur portable saisi.
Les métadonnées et les empreintes numériques ne disparaissent pas simplement parce que la page d’accueil indiquait « privé ».
Quand un assistant IA personnel peut accéder à votre boîte de réception
Les agents IA actuels ne se limitent pas à la fenêtre de discussion. Ils rédigent des réponses, lisent les fils de discussion, consultent les agendas et disposent des autorisations nécessaires pour le faire. La confidentialité de l’assistant dépend donc aussi du niveau de protection de tous les comptes auxquels il a accès.
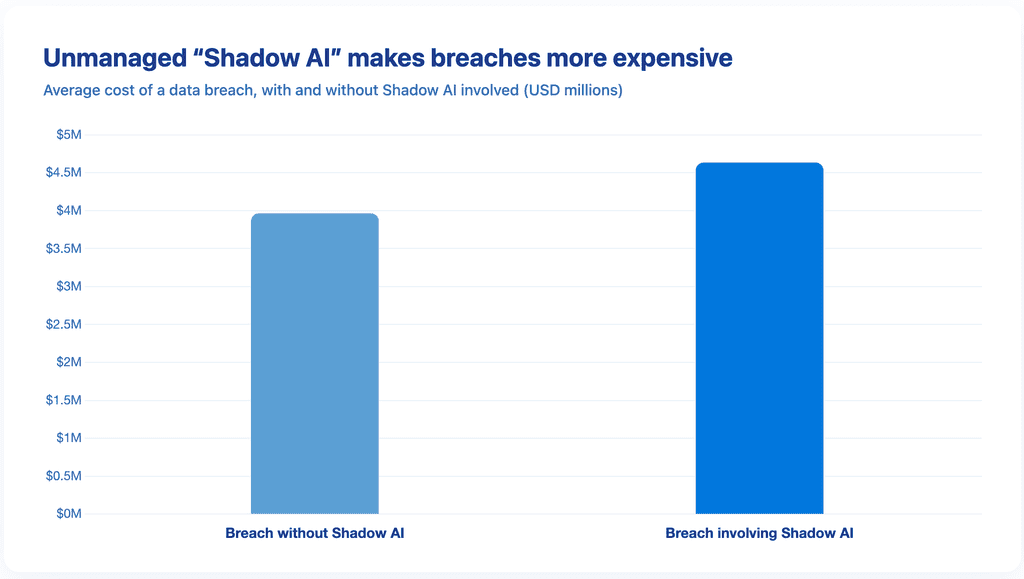
Si cette boîte mail a déjà été analysée à des fins publicitaires ou d’entraînement de modèles, l’ajout d’un agent IA ne fait qu’accroître un risque d’exposition déjà présent. Le coût de cette faille est mesurable : dans l’étude d’IBM intitulée « Cost of a Data Breach 2025 », une organisation sur cinq a signalé une violation impliquant l’IA fantôme. Les organisations présentant des niveaux élevés d’« IA fantôme » ont subi des coûts moyens liés aux violations supérieurs d’environ 670 000 dollars à ceux des organisations où l’« IA fantôme » est peu ou pas présente, tandis que 97 % des organisations ayant subi un incident de sécurité lié à l’IA ne disposaient pas de contrôles d’accès adéquats à l’IA.
Le chiffrement des e-mails ne protège pas automatiquement un message une fois qu’un agent l’a déchiffré et qu’il est autorisé à transmettre son contenu à un modèle externe. Le chiffrement protège le message tant qu’il reste au sein du système chiffré ; il ne permet pas de contrôler ce que fait une application de confiance une fois qu’elle a obtenu un accès légitime au texte en clair.
Mailfence n’est pas un produit d’IA privée. C’est un service de messagerie et de stockage de fichiers que ces agents ne devraient pas transmettre à un service d’IA externe sans précaution. Il propose notamment le chiffrement de bout en bout, l’absence de publicité et un hébergement en Belgique. L’assistant et la boîte mail doivent être considérés comme un même ensemble du point de vue de la sécurité.
« Les gens ne cessent de demander si une IA s’entraîne à partir de leurs données. Ce n’est pas la bonne question à poser en premier lieu. Demandez plutôt qui peut lire ce que vous avez tapé pendant que le modèle y répond, et à qui appartient le profil qu’il conserve par la suite. Si vous ne pouvez pas désigner la machine, vous n’avez pas de vie privée. » – Patrick De Schutter, cofondateur de Mailfence
Comment choisir une IA privée
Commencez par évaluer la sensibilité du texte que vous vous apprêtez à transmettre. Choisissez ensuite l’outil en fonction du niveau de protection nécessaire.
- Pour vos notes personnelles et vos écrits quotidiens, utilisez une application locale telle que Jan, LM Studio ou Ollama. Dans une configuration strictement locale, les données peuvent rester sur votre appareil.
- Pour mettre une IA à la disposition de tout votre foyer ou d’une petite équipe, configurez votre propre serveur d’IA privé, accessible à tout moment.
- Des questions rapides posées depuis la barre latérale d’un navigateur, avec un fournisseur qui ne conserve pas vos conversations : Brave Leo AI.
- Un historique de discussion que le prestataire lui-même ne peut pas rouvrir : Lumo.
- Une IA dans le cloud, mais avec la garantie matérielle que vos données sont isolées pendant son exécution : Venice AI.
- Données qui ne doivent pas sortir de vos locaux pour des raisons légales ou contractuelles : une installation sur site.
- Si vous privilégiez avant tout les performances, ChatGPT peut être un choix pertinent. Veillez toutefois à distinguer les différentes offres et leurs garanties de confidentialité.
Vous souhaitez exécuter localement des grands modèles de langage (LLM) ? Harish vous explique ici comment procéder, ainsi que les avantages que cela présente pour la protection de votre vie privée.
Quel que soit votre choix, vérifiez les points suivants avant de cliquer sur « Envoyer » :
- Est-ce que je remettrais ce texte à un inconnu dans cette entreprise ?
- Le fait de « ne pas s’entraîner » correspond-il réellement à la protection dont j’ai besoin ou s’agit-il seulement d’une première étape ?
- Cela pourrait-il fonctionner sur mon propre ordinateur à la place ?
- Ai-je copié-collé ces données moi-même, ou une extension ou un module complémentaire les a-t-il envoyées à ma place ?
- Puis-je identifier précisément la machine sur laquelle mes données seront traitées ?
Points clés à retenir
– Une IA privée repose sur un périmètre de sécurité que vous pouvez définir, et non sur un simple bouton permettant d’activer ou de désactiver l’entraînement du modèle.
– Deux voies s’offrent à vous : exécuter le modèle vous-même ou faire appel à un hébergeur – les hébergeurs proposent différents niveaux de confidentialité.
– Le fait de ne pas utiliser vos données pour entraîner le modèle ne signifie pas que le fournisseur ne peut pas y accéder pendant leur traitement.
– Le chiffrement de votre historique enregistré ne signifie pas que votre requête en temps réel reste invisible.
– Un chatbot grand public dont l’entraînement est désactivé constitue la forme la plus faible d’IA privée.
– Le profil que votre assistant établit à partir de vos données doit être pris en compte au même titre que la requête que vous venez de saisir.
Dernières réflexions
Les outils hébergés par un fournisseur peuvent offrir un niveau de confidentialité supérieur à celui de ChatGPT sans être installés localement. Les outils locaux peuvent néanmoins faire l’objet de fuites via un plugin, un port ouvert ou un disque saisi.
Qui peut consulter vos requêtes et qui contrôle les données mémorisées ? Voilà les questions essentielles. Le reste relève souvent davantage du discours marketing que de garanties techniques vérifiables.
Si votre assistant doit accéder à vos e-mails ou à vos fichiers, commencez par utiliser une boîte mail dont vous contrôlez l’accès et les paramètres de confidentialité. Vous pouvez notamment créer un compte Mailfence.
La vie privée est un droit, pas une fonctionnalité. Cela vaut aussi pour le texte que vous vous apprêtez à copier-coller.
Glossaire
- Attestation : une validation cryptographique qui garantit qu’un environnement informatique confidentiel correspond précisément à ce qu’il prétend être. Elle vous permet de vérifier l’isolation réelle de vos données, plutôt que de vous contenter d’une simple mention marketing figurant sur une grille tarifaire.
- Périmètre de sécurité : zone dans laquelle le modèle, les données et le processus de génération des réponses restent confinés. Il peut s’agir de votre appareil, de votre serveur privé ou d’un compte bien délimité dans lequel vos documents et le processus de génération des réponses restent confinés.
- Informatique confidentielle : ensemble de technologies matérielles permettant de traiter des données dans des enclaves sécurisées, de manière à empêcher l’opérateur de la machine de les consulter pendant leur traitement.
- Données en cours d’utilisation : données temporairement accessibles en mémoire pendant leur traitement, notamment après leur déchiffrement lorsque celui-ci est nécessaire. Le chiffrement en transit et au repos ne protègent pas cette phase précise, ce qui rend le choix de l’infrastructure et la maîtrise du matériel indispensables.
- Apprentissage fédéré : méthode d’entraînement d’un modèle à partir de données réparties sur plusieurs appareils ou systèmes. Les données brutes restent sur ces appareils ; seuls des paramètres ou des mises à jour du modèle sont transmis pour contribuer à l’entraînement.
- Chiffrement homomorphe : une technique mathématique avancée qui permet à une machine d’effectuer des calculs complexes directement sur des données chiffrées, produisant une réponse sans jamais avoir besoin d’accéder au texte en clair. Une technique prometteuse, mais dont le coût de calcul reste un obstacle à une utilisation généralisée dans les chatbots.
- Inférence : processus par lequel un modèle déjà entraîné traite de nouvelles données pour produire une réponse, une prédiction ou un autre résultat. C’est précisément à cet instant que vos données sont manipulées et que leur confidentialité est soit préservée, soit compromise.
- « Shadow AI » : l’utilisation clandestine ou non autorisée d’outils d’IA publics par des salariés au sein d’une organisation, en dehors de tout cadre de gouvernance informatique. Il s’agit aujourd’hui de l’un des principaux moyens par lesquels des informations sensibles peuvent être exposées à des plateformes tierces.
- Calcul multipartite sécurisé : une famille de protocoles cryptographiques qui permet à plusieurs acteurs de calculer un résultat commun tout en gardant leurs données d’entrée strictement secrètes. Personne n’a une vue d’ensemble, et seul le résultat final validé est révélé.
- TEE (Trusted Execution Environment, ou environnement d’exécution de confiance) : zone isolée au sein d’un processeur qui protège matériellement le code et les données contre les accès non autorisés du reste du système, y compris ceux des administrateurs, pendant leur traitement.
- Poids du modèle : valeurs numériques apprises pendant l’entraînement qui déterminent en partie le comportement du modèle d’IA. Les « poids ouverts » (comme Llama, Mistral ou Gemma) sont ceux que vous pouvez librement télécharger et faire tourner sur votre propre matériel.
- Stockage à accès nul du fournisseur : mode de stockage dans lequel l’historique des conversations est chiffré de telle sorte que le fournisseur ne dispose pas des clés nécessaires pour le déchiffrer. Vos archives restent stockées sur ses serveurs, mais demeurent totalement illisibles pour lui.
L'IA privée est-elle plus respectueuse de la vie privée que ChatGPT ?
Oui, à condition de choisir une solution offrant des garanties de confidentialité supérieures à celles de la version grand public de ChatGPT. ChatGPT peut être plus performant sur certains plans, tandis qu’une IA privée peut offrir un meilleur contrôle sur les données que vous transmettez au modèle.
Puis-je utiliser l'IA en privé sans avoir de compétences techniques ?
Oui, dans une certaine mesure. Installez LM Studio ou Jan, choisissez un modèle quantifié de petite taille, puis désactivez le recours automatique à un service cloud.
Quelle est la meilleure IA privée pour un usage personnel ?
Le meilleur choix est celui qui correspond à vos besoins. Privilégiez une solution locale si les données ne doivent pas quitter votre appareil, Lumo si vous souhaitez conserver votre historique, ou Brave Leo si vous recherchez un assistant intégré au navigateur qui ne nécessite pas de compte. Il n’existe pas de solution d’IA privée idéale dans tous les cas.
Lumo, Brave Leo et Venice AI sont-ils des services d’IA privée ?
Oui, chacun d’entre eux fonctionne sur un environnement hébergé. Lumo conserve votre historique dans un espace de stockage à accès zéro. Brave Leo n’effectue aucune conservation de données et ajoute un proxy entre vous et le modèle. Venice ne conserve rien par défaut, avec une protection TEE/E2EE dans ses modes les plus sécurisés. N’oubliez pas : aucun d’entre eux n’est local, sauf si vous le configurez pour utiliser un modèle s’exécutant sur votre propre machine.
Une IA privée peut-elle fonctionner entièrement sur site ?
Oui. Les poids du modèle, les documents et les traitements peuvent rester au sein de votre établissement. Cela permet d’obtenir un niveau élevé de contrôle sur l’infrastructure et les données.
Un assistant IA personnel relève-t-il de l'IA privée ?
Seulement si tous ses composants respectent les exigences de confidentialité définies. Un agent IA personnel est bien plus qu’un simple modèle : c’est un assistant qui agit en votre nom, en lisant vos fichiers, en naviguant sur Internet et, parfois, en utilisant vos identifiants. Chacune de ces actions représente un risque que vos données quittent votre appareil. La confidentialité de l’ensemble du système dépend notamment du niveau de sécurité de l’outil le moins sécurisé auquel l’agent accède. Un modèle fonctionnant en local ne vous protège pas si l’un de ses plugins envoie discrètement votre texte vers le serveur d’un tiers.
La mention « nous n'utilisons pas vos données pour l'entraînement » est-elle suffisante pour garantir la confidentialité de l'IA ?
Non. L’entraînement du modèle, la conservation des données et l’accès à celles-ci pendant leur traitement sont trois questions distinctes. Un hébergeur peut s’engager à ne pas utiliser vos données pour entraîner ses modèles tout en pouvant y accéder pendant le fonctionnement du service.